 AI 코드 검증 루프AI Code Verification
📅
들어가기 전에 🔗
AI에게 검색 필터를 고치게 했더니 “타입 검사와 테스트가 모두 통과했습니다”라는 답이 돌아왔습니다.
그런데 브라우저에서 필터를 두 번 바꾸고 뒤로 가기를 누르면, URL은 이전 값인데 입력창은 새 값으로 남습니다.
코드가 컴파일되고 일부 테스트가 통과해도 사용자가 기대한 동작까지 확인한 것은 아닙니다.
이런 재작업을 줄이려면
기대 동작을 고정하고, 실행 결과를 다음 수정의 입력으로 돌려주는 검증 루프
가 필요합니다.
이번 글에서는 검색 필터를 예제로 실패 재현, 작은 수정, 재검증, 완료 판단을 연결해 보겠습니다.
Claude와 Codex에 같은 방식으로 적용할 수 있는 작업 요청과 완료 보고 템플릿도 함께 정리합니다.검증 기준 🔗
검증 명령이 성공했는지와 요청한 기능이 동작하는지는 따로 확인해야 합니다.
“검색 필터를 URL과 동기화해 줘”라는 요청에는 여러 해석이 가능합니다.
초기값만 읽으면 되는지, 새로고침과 뒤로 가기도 처리해야 하는지, 빈 검색어는 어떻게 표현할지 모호합니다.
AI가 구현 전에 다음처럼 관찰 가능한 기준을 받으면 수정과 검증의 방향이 같아집니다.
입력: 검색어 A로 검색한 뒤 B로 다시 검색
기대: URL의 q와 검색 입력값이 B를 표시
추가 동작: 브라우저 뒤로 가기
기대: URL의 q와 검색 입력값이 모두 A로 복원
새로고침: 복원된 A가 그대로 유지
제외 범위: 검색 API와 정렬 규칙은 변경하지 않음
여기에는 구현 방식이 들어 있지 않습니다.
useEffect를 추가할지, 상태 소유권을 바꿀지는 실제 코드를 보고 결정합니다.
기준이 동작으로 표현돼 있어야 구현이 달라져도 같은 검증을 유지할 수 있습니다.Claude Code 공식 문서는 테스트·스크린샷·기대 출력처럼 결과를 스스로 확인할 수 있는 수단을 제공하는 것을 권장합니다.
Claude Code 검증 모범 사례↗
👨💻
버그 수정이라면 정상 결과만 적지 말고, 현재 실패하는 입력과 재현 순서를 함께 제공하시기 바랍니다.
“뒤로 가기 시 상태가 어긋난다”보다 “A → B → 뒤로 가기에서 URL은 A, 입력창은 B”가 수정 방향을 좁히기 쉽습니다.
실패 재현 🔗
첫 단계는 수정 전에 문제가 실제로 재현되는지 확인하는 것입니다.
실패를 재현하지 못한 상태에서 고치면, 수정 뒤 정상 화면을 보더라도 원래 문제가 해결됐는지 판단하기 어렵습니다.
버그가 발생한 코드 버전, 실행 명령, 입력, 기대 결과, 관찰 결과를 짧게 기록합니다.
자동화할 수 있다면 회귀 테스트로 고정합니다.
회귀 테스트는 이번에 고친 문제가 다음 변경에서 다시 발생하는지 확인하는 테스트입니다.
검색 필터 사례는 브라우저의 이동 기록을 다루므로 함수 테스트만으로는 충분하지 않습니다.
import { test, expect } from "@playwright/test";

test("뒤로 가기 뒤 검색어가 URL과 함께 복원된다", async ({ page }) => {
  await page.goto("/search");
  const input = page.getByRole("textbox", { name: "검색어" });
  const submit = page.getByRole("button", { name: "검색", exact: true });

  await input.fill("alpha");
  await submit.click();
  await expect(page).toHaveURL(/\?q=alpha$/);

  await input.fill("beta");
  await submit.click();
  await expect(page).toHaveURL(/\?q=beta$/);

  await page.goBack();
  await expect(page).toHaveURL(/\?q=alpha$/);
  await expect(input).toHaveValue("alpha");

  await page.reload();
  await expect(input).toHaveValue("alpha");
});
예시는
/search가 q만 사용하는 URL을 만들고, 입력창과 버튼에 위 접근성 이름이 있는 화면을 가정합니다.
실제 저장소에서는 경로·쿼리 구조·요소 이름을 맞춰야 합니다.
여러 쿼리 파라미터가 있다면 문자열의 끝을 비교하기보다 URL.searchParams로 q를 검증하는 방식으로 바꿉니다.Playwright의
toHaveURL, toHaveValue 같은 웹 단언은 기대 조건을 만족할 때까지 재시도합니다.
일정 시간을 무조건 기다리는 방식 대신 실제 URL과 입력값을 조건으로 삼을 수 있습니다.
Playwright 단언 문서↗👍
수정 전 테스트가 실패하더라도 원인을 확인해야 합니다.
입력창을 찾지 못해 실패한 것은 필터 복원 버그를 재현한 결과가 아닙니다.
의도한 지점에서 “alpha를 기대했지만 beta가 남았다”는 실패가 나오는지 확인합니다.
수정과 재검증 🔗
실패를 고정한 뒤 원인 가설 하나를 선택해 관련 코드만 수정합니다.
예를 들어 초기 렌더링에서만 URL 값을 읽는 구조라면, 뒤로 가기로 쿼리가 바뀌었을 때 입력 상태가 갱신되는지 확인합니다.
이때 검색 API나 정렬 규칙까지 동시에 바꾸면 어떤 변경이 문제를 해결했는지 추적하기 어려워집니다.
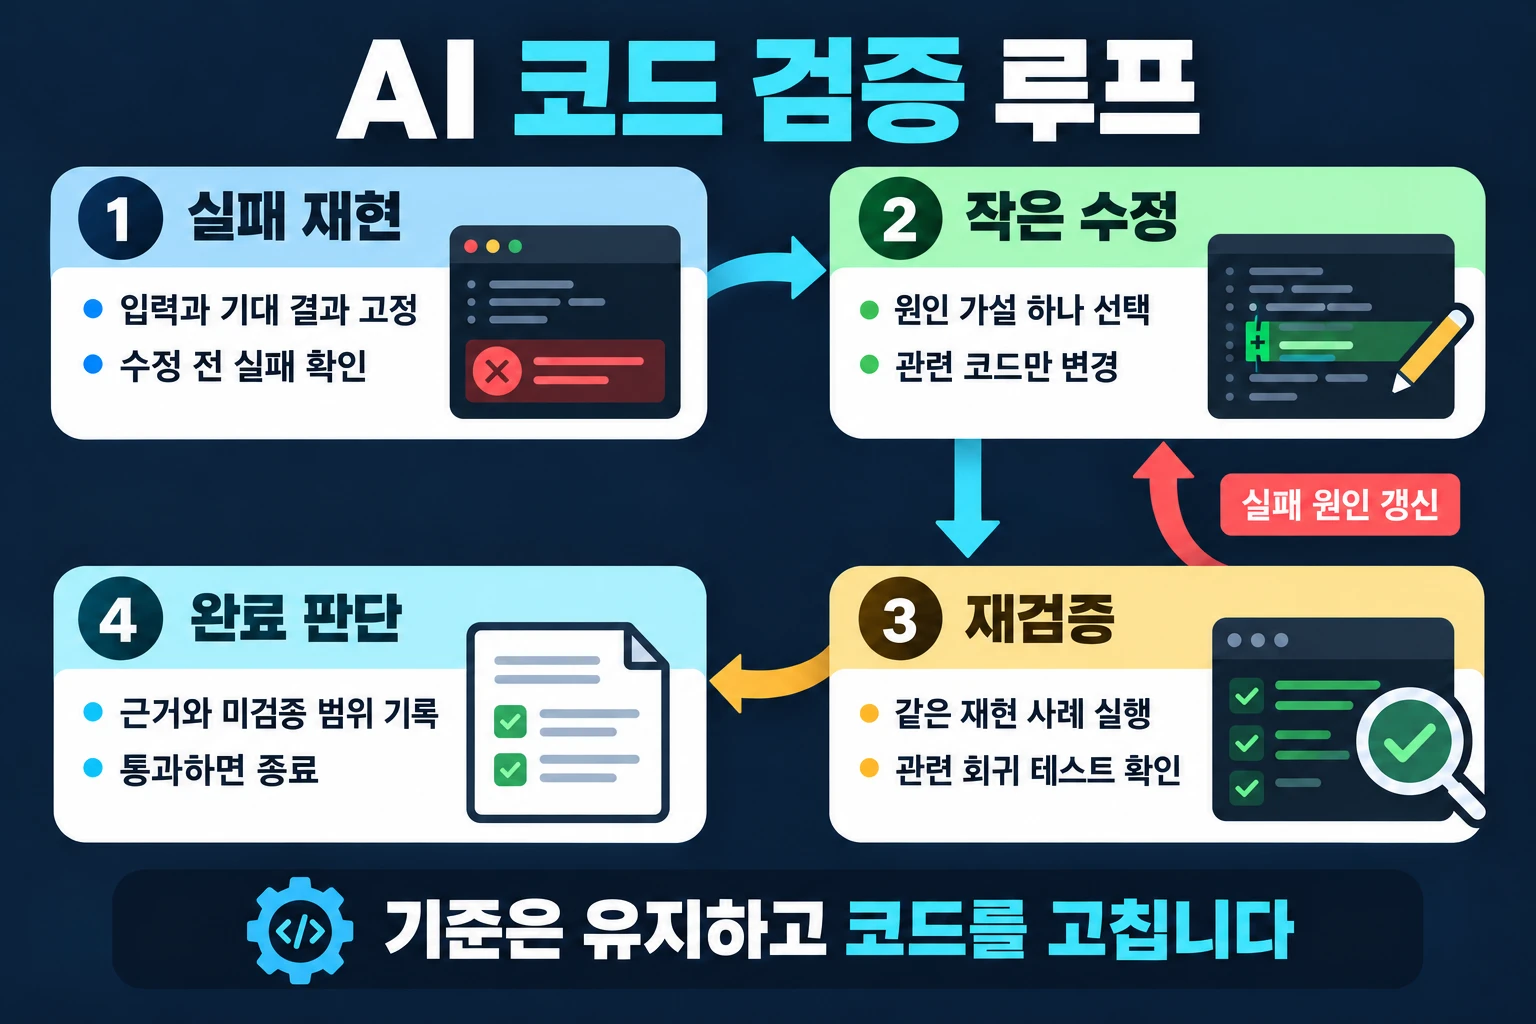
실패 재현, 작은 수정, 재검증, 완료 판단과 실패 시 수정 단계로 돌아가는 AI 코드 검증 루프
수정 뒤에는 같은 입력과 같은 단언으로 다시 실행합니다.
이번 문제를 잡는 테스트가 통과하면, 연결된 기존 동작도 확인합니다.
검색어 직접 입력, 빈 값 처리, 새로고침, 뒤로 가기처럼 변경의 영향을 받는 경로를 선택합니다.
OpenAI의 Codex 예제도 검토·수정·검증을 연결하고, 남은 실패를 다음 수정의 입력으로 전달하는 반복 구조를 설명합니다.
OpenAI의 반복 수정 루프 예제↗
검증 순서 🔗
처음부터 전체 E2E 테스트와 빌드를 반복하기보다, 변경에 맞는 빠른 검사로 시작하고 필요한 범위를 넓힙니다.
다만 버그를 직접 재현하는 테스트는 초기에 포함해야 합니다.
타입 검사가 빠르다는 이유로 브라우저 버그의 재현을 마지막까지 미루지는 않습니다.
| 검증 | 확인하는 것 | 별도로 확인할 것 |
|---|---|---|
| 타입·린트 | 타입 계약, 정적 규칙 위반 | 사용자 동작, 실행 중 데이터 |
| 단위 테스트 | 함수·컴포넌트의 입력과 출력 | 실제 API·DB 연결 |
| 통합 테스트 | 모듈과 API·데이터 계층의 연결 | 실제 브라우저 이동과 화면 상태 |
| 브라우저 검증 | 클릭·새로고침·뒤로 가기 등 사용자 흐름 | 다른 권한·예외 조건과 운영 환경 |
| 빌드 | 배포 산출물을 만드는 과정 | 배포 후 서비스의 실제 동작 |
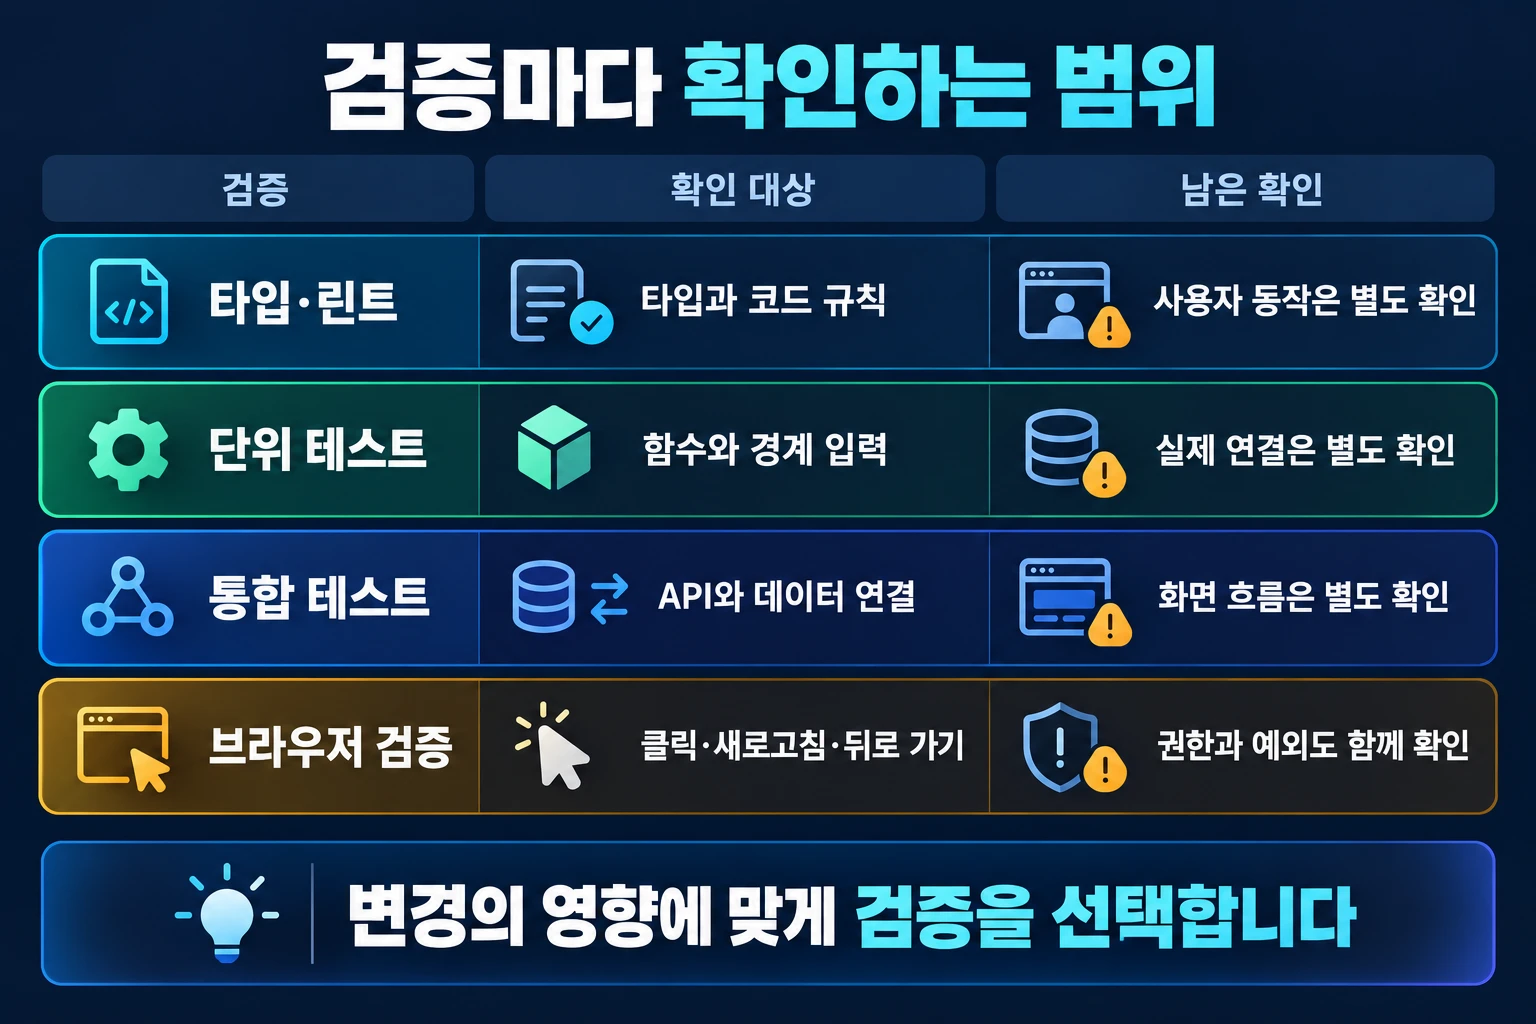
타입 검사, 단위 테스트, 통합 테스트, 브라우저 검증마다 확인 대상과 남은 확인 범위를 비교한 인포그래픽
예시 저장소에
typecheck, test, build 스크립트와 Playwright가 설정돼 있다면 다음처럼 검사할 수 있습니다.
현재 프로젝트의 package.json과 테스트 설정을 확인한 뒤 실제 명령으로 바꿉니다.npm run typecheck
npm run test -- tests/search-state.test.ts
npx playwright test tests/search-history.spec.ts
npm run build단순 문구 수정에 이 명령을 매번 전부 실행할 필요는 없습니다.
의존성·빌드 설정 변경에는 빌드를, API 응답 변경에는 연결된 소비자 테스트를 추가하는 식으로 영향에 맞춰 선택합니다.
권한 변경이라면 정상 사용자뿐 아니라 접근하면 안 되는 사용자의 결과도 확인합니다.
실패 피드백 🔗
AI에게 “테스트 실패했어, 다시 고쳐”만 전달하면 같은 가설을 반복할 수 있습니다.
전체 로그를 붙여 넣기 전에 실패한 명령, 테스트 이름, 기대값과 관찰값, 관련 로그 위치를 정리합니다.
원본 로그는 필요할 때 다시 읽을 수 있도록 보관합니다.
명령: npx playwright test tests/search-history.spec.ts
실패: 뒤로 가기 뒤 검색어가 URL과 함께 복원된다
기대: 입력값 alpha
관찰: URL은 q=alpha, 입력값은 beta
통과: 첫 검색, 두 번째 검색, URL의 뒤로 가기
변경: SearchForm의 초기값 처리
다음 확인: URL 변경을 입력 상태가 다시 읽는지
로그: test-results/search-history/error-context.md
실패 요약에는 실제로 확인한 사실과 다음 가설을 구분해 적습니다.
“URL은 바뀌었다”는 관찰이고, “상태 동기화가 빠졌다”는 아직 확인해야 할 가설입니다.
이 구분이 있어야 AI가 추측을 확정된 원인처럼 취급하지 않습니다.
중단 조건 🔗
재시도는 새 근거가 생길 때 의미가 있습니다.
아래처럼 계속할 조건과 멈출 조건을 작업 요청에 넣어 둘 수 있습니다.
- 재현 테스트와 관련 회귀 검사가 통과하면 완료 보고로 이동합니다.
- 같은 실패가 반복되고 새로운 관찰이 없으면 변경을 멈추고 원인 분석으로 돌아갑니다.
- 실행 환경이 없어 확인할 수 없으면 미검증 항목과 재현 방법을 남깁니다.
- 요구사항이나 권한 정책의 결정이 필요하면 결정할 내용을 사용자에게 전달합니다.
OpenAI의 반복 수정 예제도 검증 통과, 시도 횟수 제한, 개선 정체, 사람의 검토 필요를 종료 조건으로 제시합니다.
OpenAI의 반복 수정 루프 종료 조건↗
🖐️
통과시키기 위해 테스트를 삭제하거나 기대값을 현재의 잘못된 결과로 바꾸지 마십시오.
요구사항 변경이 확인되지 않았다면 검증 기준을 유지하고 구현을 고쳐야 합니다.
완료 근거 🔗
“모두 정상입니다”보다 검증 범위가 드러나는 보고가 다음 작업에 도움이 됩니다.
실행한 명령, 확인한 동작, 남은 한계를 구분하면 사람이 무엇을 더 볼지 바로 판단할 수 있습니다.
변경: URL 변경 시 검색 입력값도 동기화
통과: 타입 검사, 검색 상태 단위 테스트
통과: alpha → beta → 뒤로 가기 → 새로고침 E2E
확인: URL과 입력값이 alpha로 복원
미검증: Safari 실행 환경이 없어 해당 브라우저 미확인
제외: 검색 API와 정렬 규칙은 변경하지 않음
위 보고는 형식을 설명하는 예시이며, 이 글에서 실제 서비스에 실행한 결과는 아닙니다.
실제 작업에서는 확인하지 않은 명령이나 브라우저를 통과 목록에 넣지 않습니다.
👨💻
검증 뒤 코드를 다시 수정했다면 그 수정에 영향을 받는 검사를 다시 실행합니다.
이전 버전의 통과 결과를 최종 코드의 근거로 재사용하지 않습니다.
작업 요청 템플릿 🔗
Claude와 Codex에 다음 요청을 작업 내용에 맞춰 전달할 수 있습니다.
명령과 완료 조건을 구체적으로 적으면 AI가 코드 작성과 검증을 하나의 작업으로 다룰 수 있습니다.
목표: 검색 필터의 뒤로 가기 복원 오류 수정
재현: alpha로 검색 → beta로 검색 → 뒤로 가기
기대: URL과 입력값이 모두 alpha, 새로고침 뒤에도 유지
범위: 검색 폼 상태와 관련 테스트
검증: 기존 package.json의 타입 검사와 관련 테스트 실행
회귀: 위 재현을 잡는 테스트를 수정 전후로 확인
재시도: 같은 실패에 새 근거가 없으면 원인과 상태를 보고
완료 보고: 변경 요약, 실행 명령, 결과, 미검증 범위
작은 수정에는 필요한 항목만 사용합니다.
모든 작업에 긴 템플릿을 반복하기보다, 오류를 판단할 기준과 확인할 수단이 빠지지 않도록 유지합니다.
결론 🔗
AI 코드 검증 루프는 기대 동작을 고정하고, 실패를 재현한 뒤 작은 수정과 실행 결과를 연결하는 방식입니다.
타입·테스트·브라우저 검증은 각각 확인하는 범위가 다르므로 변경의 영향에 맞춰 선택해야 합니다.
실패를 다음 수정의 근거로 돌려주고, 최종 코드에서 확인한 결과를 남기는 것
이 루프의 핵심입니다.
이 흐름을 작업 요청에 포함하면 반복되는 설명과 추측성 수정을 줄이고, 사람이 검토할 범위도 분명해집니다.