 네트워크 코어와 패킷 교환Network Core - Packet Switching, Circuit Switching, and ISP Structure
📅
들어가기 전에 🔗
트래픽이 몰리는 이벤트 시간에 API 응답이 느려지고 일부 요청은 타임아웃이 납니다.
서버 CPU와 메모리는 여유가 있는데 사용자 쪽에서는 지연이 커집니다.
이런 현상은 인터넷이 회선을 미리 예약하지 않고
패킷 단위로 링크를 나눠 쓰는
구조라는 점과 관련이 있습니다.이번 글에서는 엣지 너머에서 패킷을 실어 나르는
네트워크 코어
(network core)를 살펴봅니다.
인터넷이 사용하는 패킷 교환
의 동작 원리와 전화망이 사용해 온 회선 교환
을 비교하고, 수많은 ISP가 어떻게 연결되어 있는지 정리합니다.패킷 교환 🔗
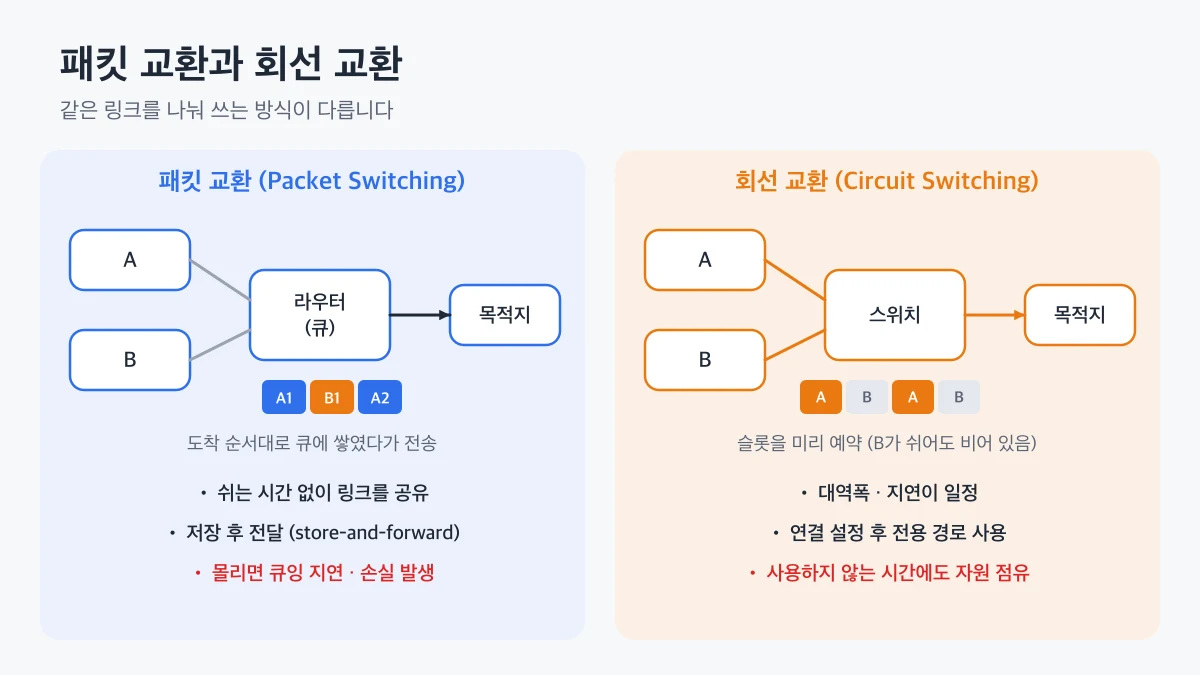
패킷 교환은 메시지를 패킷으로 나누고, 각 패킷이 필요한 순간에만 링크의 전체 전송률을 사용하게 하는 방식입니다.
저장 후 전달 🔗
라우터는 패킷의 첫 비트가 들어오자마자 다음 링크로 내보내지 않습니다.
패킷 전체를 받아 저장한 다음에야 출력 링크로 전송을 시작하는데, 이를
저장 후 전달
(store-and-forward)이라고 합니다.크기가 L 비트인 패킷을 전송률 R bps 링크로 내보내는 데는 L/R초가 걸립니다.
출발지와 목적지 사이에 링크가 N개 있으면, 큐잉과 전파 지연을 무시할 때 패킷 하나의 종단 간 지연은 N × L/R입니다.
| 조건 | 값 |
|---|---|
| 패킷 크기 L | 1,500바이트 = 12,000비트 |
| 링크 전송률 R | 10 Mbps |
| 링크 수 N | 3 |
| 링크 하나의 전송 시간 L/R | 1.2 ms |
| 종단 간 지연 N × L/R | 3.6 ms |
큐잉 지연과 패킷 손실 🔗
라우터의 각 출력 링크에는
출력 버퍼
(output buffer), 즉 큐가 있습니다.
출력 링크가 다른 패킷을 보내는 중이면 새로 도착한 패킷은 큐에서 기다려야 하며, 이 대기 시간이 큐잉 지연
입니다.큐는 자료구조의
FIFO 큐
처럼 먼저 들어온 패킷부터 내보냅니다.
하지만 버퍼 크기는 유한하므로, 큐가 가득 찬 상태에서 패킷이 더 도착하면 새 패킷이나 대기 중인 패킷이 버려집니다.
이것이 패킷 손실
이며, 트래픽이 몰리는 시간에 응답이 느려지고 재전송이 늘어나는 원인입니다.const capacity = 3;
const queue = [];
function arrive(packet) {
if (queue.length >= capacity) return console.log(`drop ${packet}`);
queue.push(packet);
console.log(`enqueue ${packet} (size=${queue.length})`);
}
function transmit() {
const packet = queue.shift();
if (packet) console.log(`send ${packet}`);
}
["A1", "B1", "A2", "C1", "B2"].forEach(arrive);
transmit();
arrive("C2");이 코드를 실행하면 버퍼 크기가 3이므로
C1과 B2는 버려지고, 하나를 전송해 자리가 생긴 뒤에야 C2가 큐에 들어갑니다.
실제 라우터는 이보다 훨씬 큰 버퍼와 다양한 스케줄링 정책을 사용하지만, 버퍼가 유한하면 손실이 생긴다
는 원리는 같습니다.포워딩 테이블과 라우팅 🔗
라우터는 패킷 헤더의 목적지 IP 주소를 보고 어느 출력 링크로 보낼지 결정합니다.
이때 참고하는 표가
포워딩 테이블
(forwarding table)이며, 목적지 주소 범위를 출력 링크에 대응시킵니다.포워딩 테이블은 사람이 일일이 작성하지 않습니다.
라우터들이
라우팅 프로토콜
로 경로 정보를 교환하고, 그 결과로 테이블을 자동으로 만듭니다.
패킷 하나를 다음 링크로 넘기는 일이 포워딩, 전체 경로를 계산하는 일이 라우팅
이라고 구분하면 이후 네트워크 계층을 공부할 때 도움이 됩니다.패킷 교환은 라우터 큐에 도착 순서대로 패킷을 쌓아 링크를 공유하고, 회선 교환은 슬롯을 미리 예약해 전용 경로를 사용하는 차이
회선 교환 🔗
회선 교환은 통신을 시작하기 전에 경로상의 자원을 예약하고, 통신이 끝날 때까지 그 자원을 전용으로 사용하는 방식입니다.
전통적인 전화망이 대표적인 회선 교환 네트워크입니다.
전화를 걸면 발신자와 수신자 사이의 스위치들이 연결 상태를 유지하고, 링크 용량의 일정 부분을 이 통화에 할당합니다.
그래서 통화 중에는
일정한 전송률과 지연
이 보장됩니다.FDM과 TDM 🔗
링크 하나를 여러 회선이 나눠 쓰는 방법은 두 가지입니다.
- FDM(Frequency-Division Multiplexing) 주파수 대역을 나누어 각 회선에 할당합니다. 라디오 방송국이 서로 다른 주파수를 쓰는 방식과 같습니다.
- TDM(Time-Division Multiplexing) 시간을 프레임과 슬롯으로 나누고, 각 회선이 매 프레임마다 정해진 슬롯을 사용합니다.
두 방식 모두 회선이 데이터를 보내지 않는
휴지 시간
(silent period)에도 할당된 자원을 다른 사용자가 쓸 수 없습니다.패킷 교환과 회선 교환 비교 🔗
1 Mbps 링크를 여러 사용자가 공유한다고 가정해 보겠습니다.
각 사용자는 활동할 때 100 kbps로 전송하고, 전체 시간의 10%만 활동합니다.
| 방식 | 수용 가능한 사용자 | 근거 |
|---|---|---|
| 회선 교환 | 10명 | 1 Mbps ÷ 100 kbps, 사용자마다 100 kbps를 상시 예약 |
| 패킷 교환 | 35명 | 동시에 11명 이상 활동할 확률이 약 0.0004 |
35명 중 동시에 활동하는 사람이 10명 이하라면 전체 전송률은 1 Mbps를 넘지 않으므로 큐잉 지연이 거의 생기지 않습니다.
이항분포로 계산하면 11명 이상이 동시에 활동할 확률은 약 0.04%입니다.
즉
패킷 교환은 같은 링크로 3배 이상 많은 사용자를 거의 같은 품질로 수용
할 수 있습니다.반면 실시간 통화처럼 일정한 지연이 중요한 서비스에서는 패킷 교환의 지연 변동이 단점이 됩니다.
그래서 인터넷 전화와 화상 회의 서비스는 지터 버퍼, 손실 은닉 같은 기법으로 패킷 교환의 변동성을 보완합니다.
👨💻
서비스의 트래픽이 특정 시간에 몰린다면 서버 성능만큼
요청 분산과 재시도 정책
도 중요합니다.
모든 클라이언트가 동시에 재시도하면 이미 가득 찬 큐에 패킷이 더 몰려 손실이 커지므로, 재시도 간격에 무작위 지연을 섞는 지수 백오프를 적용합니다.네트워크들의 네트워크 🔗
ISP 계층 구조 🔗
가정과 회사를 연결하는 접속 ISP만으로는 전 세계 호스트를 연결할 수 없습니다.
접속 ISP는 지역 ISP에, 지역 ISP는 다시 전 세계에 망을 가진
티어 1 ISP
에 연결되며, 하위 ISP는 상위 ISP에 요금을 내는 고객
(customer)이 됩니다.현재 인터넷에는 이 단순한 계층 외에도 다음 요소가 더해져 있습니다.
- PoP(Point of Presence) 상위 ISP가 하위 ISP를 연결하기 위해 둔 라우터 묶음입니다.
- 멀티홈(multi-homing) 하나의 ISP가 둘 이상의 상위 ISP에 연결해 한쪽에 장애가 나도 연결을 유지합니다.
- 피어링(peering) 같은 계층의 ISP끼리 서로 요금 없이 트래픽을 직접 교환합니다.
- IXP(Internet Exchange Point) 여러 ISP와 CDN이 한 장소에서 서로 연결하는 물리적 거점입니다 (Cloudflare · What is an Internet exchange point?↗).
콘텐츠 제공자 네트워크 🔗
대형 콘텐츠 기업과 CDN은 자체 데이터센터를 전용 네트워크로 연결합니다.
그리고 상위 ISP를 거치지 않고 접속 ISP나 IXP에 직접 연결해 사용자에게 더 가까운 곳에서 콘텐츠를 전달합니다.
이 덕분에 상위 ISP에 내는 비용을 줄이고, 사용자 입장에서는 지연이 줄어듭니다.
이렇게 각자 독립적인 라우팅 정책으로 운영되는 네트워크 단위를
자율 시스템
(AS)이라고 부르며, 각 AS는 고유한 ASN을 가집니다 (Cloudflare · What is an autonomous system?↗).
AS 사이의 경로 정보를 교환하는 프로토콜은 이후 라우팅을 다룰 때 자세히 살펴봅니다.결론 🔗
네트워크 코어는
패킷 교환
방식으로 동작합니다.
라우터는 패킷을 저장한 뒤 포워딩 테이블을 보고 다음 링크로 전달하며, 출력 링크가 바쁘면 큐에서 기다리게 하고 큐가 넘치면 패킷을 버립니다.
회선 교환은 일정한 품질을 보장하지만, 쉬는 시간에도 자원을 점유해 같은 링크로 수용할 수 있는 사용자가 적습니다.이벤트 시간에 응답이 느려진다면 서버 자원뿐 아니라 경로상의 큐잉과 손실도 함께 의심하고, 재시도 정책이 혼잡을 키우지 않는지 확인해 보세요.
다음 글에서는 이 큐잉 지연을 포함해 패킷이 겪는
네 가지 지연과 손실, 처리량
을 수치로 계산해 봅니다.