你收到反馈:一个页面对首尔的用户很快,对美国的用户却很慢。
服务器响应时间日志显示两边都是 50 ms,但用户实际感受到的时间却相差好几倍。
这个差异产生于服务器之外,也就是
分组穿越网络时累积的时延
。
本文将区分分组经过一台路由器时产生的
四种时延
,并梳理各自的计算方法。
接着介绍产生
丢包
的条件,以及决定端到端
吞吐量
的瓶颈链路,最后用 macOS 命令测量实际数值。
节点时延是处理时延、排队时延、传输时延和传播时延之和。
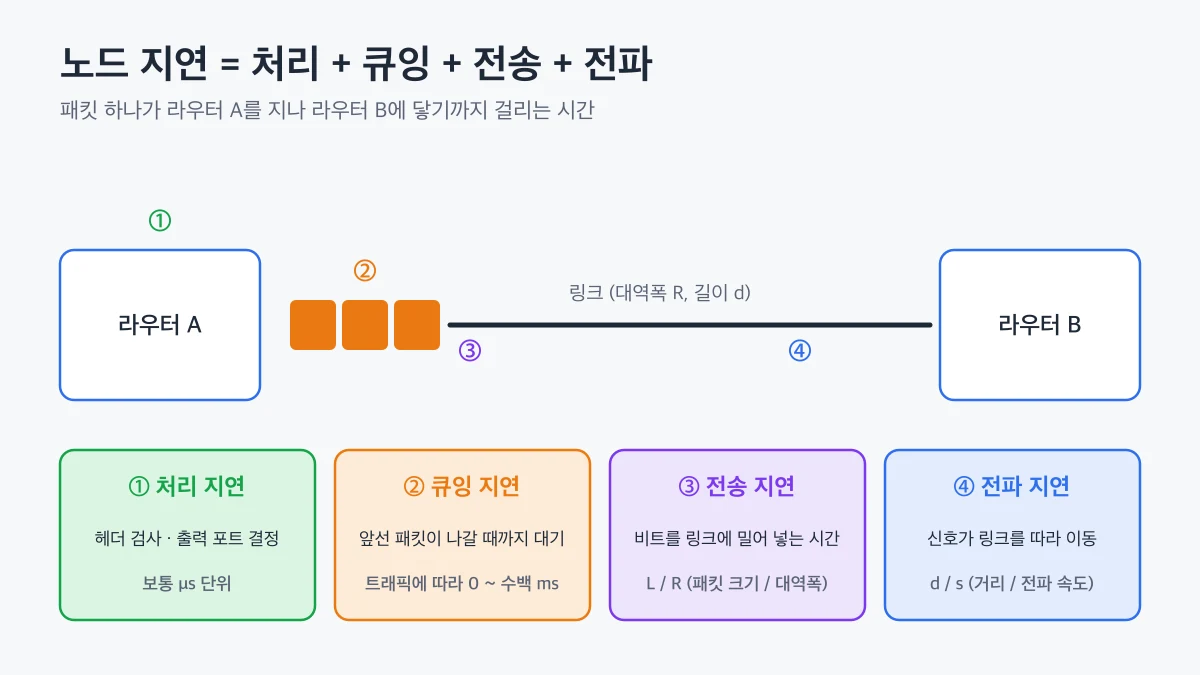
从路由器 A 发往路由器 B 的分组所经历的处理时延、排队时延、传输时延和传播时延的位置及计算公式
路由器检查分组首部、检测比特错误,并决定把分组发往哪条输出链路。
完成这些工作所需的时间就是
处理时延
(processing delay),在现代路由器中通常为微秒级,非常小。
如果输出链路正在发送其他分组,新分组就会在队列中等待。
这段等待时间就是
排队时延
(queuing delay)。
排队时延取决于
排在前面的分组数量
,因此是四种时延中波动最大的。
没有流量时接近于零,但在拥塞时可能增大到数十甚至数百毫秒。
传输时延
(transmission delay)是把分组的所有比特推送到链路上所需的时间。
设分组大小为 L 比特,链路传输速率为 R bps,则传输时延为 L/R。
传输时延
与链路长度无关
,只受分组大小和链路速度的影响。
传播时延
(propagation delay)是被推送到链路上的比特传播到对端路由器所需的时间。
设链路长度为 d,信号在媒体中的传播速度为 s,则传播时延为 d/s。
在光纤或铜线中,信号速度大约为 2 × 10⁸ m/s,比光速略慢。
这两种时延名称相近,常被混淆。
用高速公路收费站来比喻:10 辆车全部通过收费站所需的时间是传输时延,最后一辆车开到下一个收费站所需的时间是传播时延。
下表以 1,500 字节的分组为基准,计算了两种时延。
| 区段 | 条件 | 传输时延 L/R | 传播时延 d/s |
|---|
| 办公室局域网 | 100 Mbps,100 m | 0.12 ms | 0.0005 ms |
|---|
| 首尔–洛杉矶海底区段 | 100 Mbps,约 9,600 km | 0.12 ms | 约 48 ms |
|---|
在相同传输速率下,传输时延相同,但随着距离增加,传播时延会变得压倒性地大。
跨洲服务变慢的最大原因是物理距离,而不是带宽
,因此借助 CDN 和多区域部署把服务器放到离用户更近的地方非常有效。
排队时延会变得多大,可以用
流量强度
(traffic intensity)来估算。
如果分组平均每秒到达 a 个,分组大小为 L 比特,链路传输速率为 R bps,那么流量强度为 La/R。
- La/R 接近 0 时
几乎没有分组到达,排队时延很小。
- La/R 接近 1 时
短时间内集中到达的分组开始在队列中堆积,平均排队时延急剧增大。
- La/R 大于 1 时
到达速度超过发送速度,队列无限增长,最终分组被丢弃。
🖐️
系统设计必须保证流量强度不超过 1。
如果让链路或服务器以接近 100% 的利用率运行,平均吞吐量看起来很高,但
排队时延和丢包会急剧增加
,用户体验会大幅变差。
由于路由器的队列容量有限,在队列已满时到达的分组会被丢弃。
丢失的分组会由 TCP 等上层协议重传;而在实时通话这类不重传的服务中,则会直接表现为质量下降。
因此,网络性能不仅用时延衡量,也用
丢包率
来评估。
丢包反复出现时,TCP 会判断为拥塞并降低发送速率,所以丢包最终会导致吞吐量下降。
如果源和目的地之间有 N−1 台路由器,并且网络没有拥塞,那么忽略排队时延的端到端时延为 N × (处理时延 + 传输时延 + 传播时延)。
在实际测量中,还要加上每台路由器的排队时延;又因为请求和响应是往返的,所以通常以
RTT
(Round-Trip Time)为基准。
Cloudflare 将网络时延描述为
数据分组从一个地方传到另一个地方所需的时间
,并强调降低时延是用户体验的关键(
Cloudflare · What is latency?↗)。
吞吐量
(throughput)是接收主机实际接收数据的速率。
当从服务器到客户端的路径上有多条链路时,吞吐量受限于
最慢链路
的传输速率,这条链路称为
瓶颈链路
(bottleneck link)。
| 路径 | 服务器链路 Rs | 中间链路 R | 客户端链路 Rc | 吞吐量 |
|---|
| 单个下载 | 1 Gbps | 10 Gbps | 100 Mbps | 100 Mbps |
|---|
| 10 个下载共享中间链路 | 1 Gbps | 500 Mbps | 100 Mbps | 每个连接 50 Mbps |
|---|
第一种情况下,吞吐量为 min(Rs, R, Rc),客户端链路是瓶颈。
第二种情况下,10 个连接共享 500 Mbps 的中间链路,因此每个连接 R/10,即 50 Mbps 成为瓶颈。
这个计算与在数据结构中求图路径的
最小边容量
是同一个问题。
路径的吞吐量等于路径上各边容量的最小值,因此改善非瓶颈链路不会带来效果。
👨💻
解决下载速度问题时,请先找到瓶颈所在。
如果用户的线路是 100 Mbps,即使把服务器带宽提高到 10 Gbps,用户感受到的速度也不会改变。
ping 测量到目的地的 RTT 和丢包率。
traceroute 显示到路径上每台路由器的 RTT,因此可以找出时延在哪个区段变大。
ping -c 10 www.promleeblog.com
traceroute -n -q 3 www.promleeblog.com
ping 结果最后几行中,
packet loss 表示丢包率,
round-trip min/avg/max/stddev 表示 RTT 的最小值、平均值、最大值和标准差。
标准差大,说明排队时延波动大。
在 Windows 上使用 ping -n 10 和 tracert,在 Linux 上则使用与 macOS 相同的 ping -c 10 和 traceroute。
要按阶段拆分查看 Web 请求的时延,可以使用 curl 的 -w 选项。
curl -o /dev/null -s -w "dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total}\n" https://www.promleeblog.com
time_connect
TCP 连接完成的时间点。从 DNS 查询结束到连接建立所花的时间大约相当于一次 RTT。time_appconnect
TLS 握手结束的时间点。time_starttransfer
收到第一个字节的时间点(TTFB),同时反映了服务器处理时间和网络往返时间。
如果 TTFB 远大于服务器日志中的处理时间,那么原因很可能是
网络区段的时延
。
macOS 12 Monterey 及以上版本内置了测量吞吐量和响应能力的 networkQuality 命令。
它会同时显示上传和下载吞吐量,以及在负载状态下的响应能力。
如果负载状态下的响应能力大幅下降,可以怀疑路由器或接入网中的队列堆积过多。
测量值会因时段和网络环境而变化,请多次测量后进行比较。
分组每经过一台路由器,都会累加
处理、排队、传输和传播时延
。
传输时延由分组大小和链路速度决定,传播时延由距离决定,排队时延随流量强度大幅变化,队列溢出时会导致丢包。
端到端吞吐量由路径上最慢的
瓶颈链路
决定。
如果海外用户访问慢,就把服务器放得更近以减少传播时延;如果高峰时段变慢,就检查排队和丢包;如果下载慢,就先查找瓶颈链路。
下一篇文章将介绍把这一复杂传送过程分开管理的
协议分层与封装
。