 情報源符号化
📅
概要 (Introduction) 🔗
- 情報源の記号は、二進数に符号化する必要があります。
- 平均符号長を最小化する必要があります。
- 冗長性の除去ビットレートの削減につながります。
- アルファベットに基づく離散無記憶情報源を考えます。
- の確率はです。
- の符号長はです。
- 平均符号長、つまり一記号当たりの平均ビット数はです。
- が取り得る最小値はです。
- 情報源の符号化効率はです。
- データ圧縮
- 送信前に、冗長な情報を取り除きます。
- 可逆的なデータ圧縮です。
- 離散無記憶情報源(discrete memoryless source)の出力を表す情報源符号は、一意に復号できます。
データ圧縮のための情報源符号化方式 (Source Coding Schemes for Data Compression) 🔗
接頭符号化 (Prefix Coding) 🔗
ほかの符号の接頭辞にならない可変長の情報源符号です。
- 接頭符号の性質
- 接頭符号は、一意に復号できます。
- 逆は必ずしも成り立ちません。一意に復号できる符号が、すべて接頭符号であるとは限りません。
例:接頭符号 🔗
| 記号 | 出現確率 | 符号I | 符号II | 符号III |
|---|---|---|---|---|
| s0 | 0.5 | 0 | 0 | 0 |
| s1 | 0.25 | 1 | 10 | 01 |
| s2 | 0.125 | 00 | 110 | 011 |
| s3 | 0.125 | 11 | 111 | 0111 |
Code1は接頭符号ではありません。
Code2は接頭符号です。
Code3は一意に復号できますが、接頭符号ではありません。次の符号の開始位置を判別しにくい形です。
例:Code2
0101110111 → 0/10/111/0/111と、一意に復号できます。
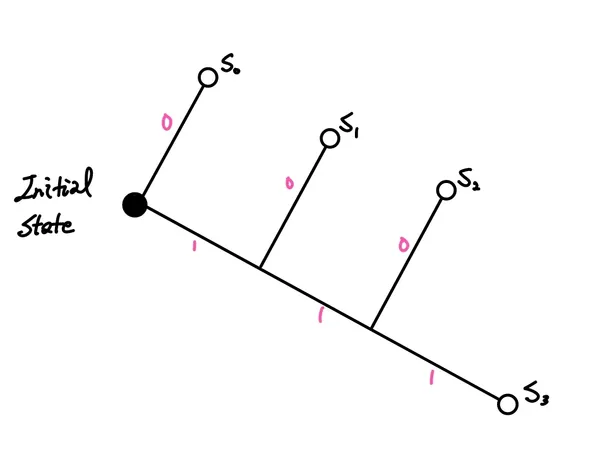
決定木
任意の記号が、確率で出現します。
- 確率の総和:
- 平均符号長:
* ハフマン符号化 (Huffman Coding) 🔗
⭐
重要
⭐ハフマン符号化のアルゴリズム 🔗
データ圧縮によく使われる方法です。
頻繁に現れる記号には短い符号を、まれに現れる記号には長い符号を割り当てて、
データを圧縮
します。- 記号の確率を大きい順に並べ、木の葉ノードとみなします。
- ノードをまとめていく間、次の処理を繰り返します。
- 最も確率の低い二つのノードを選び、低いほうに0、高いほうに1を割り当てます。逆でも構いませんが、一貫している必要があります。
- 二つを統合して新しいノードを作ります。その確率は、元の二つの確率の和です。
- 手順1へ戻ります。
- 各記号について、葉から根までの経路をたどり、二進符号を作ります。
- 葉ノードのビットは、符号語(codeword)の最後のビットになります。
ハフマン符号の特徴 🔗
接頭符号です。
各記号の符号語の長さは、その記号が伝える情報量とほぼ一致します。
確率分布が既知で正確なら、ハフマン符号は非常に効果的です。
- 分散は、符号語の長さのばらつきを表します。
- 誤りを避けるため、分散の大きいハフマン木を選びます。 → 分散が大きい木では符号長がより多様になるため、誤りに対応しやすくなります。
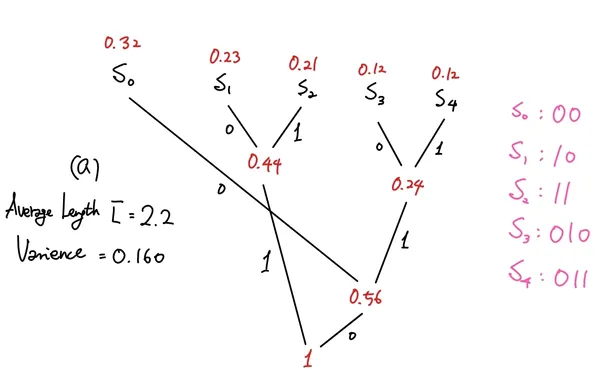
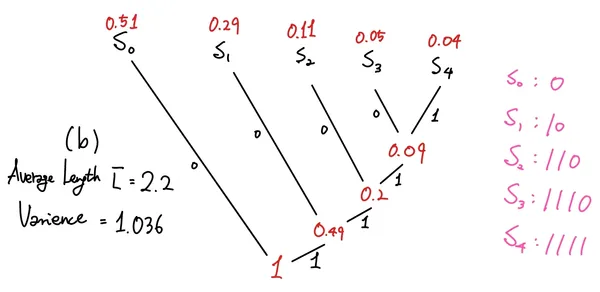
ハフマン木の構成例 (Example of Huffman Tree Construction) 🔗
二つの木の平均長は同じですが、
分散
は異なります。- 分散の大きい木は、誤りに対応しやすいという特徴があります。