有用户反馈,一个图片很多的商品详情页打开得特别慢。
服务器响应时间只有 50 ms 左右,非常快,但整个页面却要好几秒才能显示出来。
这种差距源于浏览器
不是只请求一个 HTML,而是分别请求几十个对象
,以及 HTTP 的连接方式。
在
上一篇文章中,我们整理了应用层的原则。
本文依次介绍 Web 的应用层协议
HTTP
(HyperText Transfer Protocol)如何建立连接和交换报文、用于记住状态的 Cookie,以及提升响应速度的 Web 缓存。
HTTP 是定义 Web 客户端与 Web 服务器之间交换的请求和响应报文的格式与顺序的应用层协议。
Web 页面由多个
对象
(object)组成。
有一个基础 HTML 文件,其中通过 URL 引用图片、CSS、JavaScript 文件等对象。
浏览器收到 HTML 后,会逐个额外请求被引用的对象。
HTTP 使用
TCP
作为传输协议。
客户端与服务器建立 TCP 连接后,双方通过套接字交换报文,报文的丢失和顺序由 TCP 负责。
此外,HTTP 服务器是不记住先前请求的
无状态
(stateless)协议。
即使同一个客户端两次请求同一个对象,服务器也会像第一次收到请求那样再次响应。
非持久连接
(non-persistent connection)是每交换一个对象就新建并关闭一次 TCP 连接的方式。
接收一个对象所需的时间如下。
- 建立 TCP 连接需要 1 RTT
- 发送 HTTP 请求并收到响应的第一个字节需要 1 RTT
- 传输文件的时间
RTT
(Round-Trip Time)是一个小数据包从客户端到服务器再返回所需的时间。
也就是说,在非持久连接中,每个对象需要
2 RTT + 文件传输时间
。
持久连接
(persistent connection)在建立 TCP 连接后不关闭,而是将其复用于多个请求和响应。
从 HTTP/1.1 起这是默认行为,服务器会在一段时间内没有请求时关闭连接。
如果不等待响应就连续发送请求,甚至可以在大约 1 RTT 内收到多个对象。
| 条件 | 值 |
|---|
| RTT | 50 ms |
|---|
| 对象数量 | HTML 1 个 + 图片 10 个 |
|---|
| 文件传输时间 | 忽略 |
|---|
| 非持久连接,顺序请求 | 11 × 2 RTT = 1,100 ms |
|---|
| 持久连接,顺序请求 | 1 RTT + 11 × 1 RTT = 600 ms |
|---|
| 持久连接,连续请求图片 | 1 RTT + 1 RTT + 1 RTT = 150 ms |
|---|
同一个页面,因连接方式不同,响应时间相差 7 倍以上。
因此浏览器会使用持久连接,并与服务器并行建立多个连接来减少延迟。
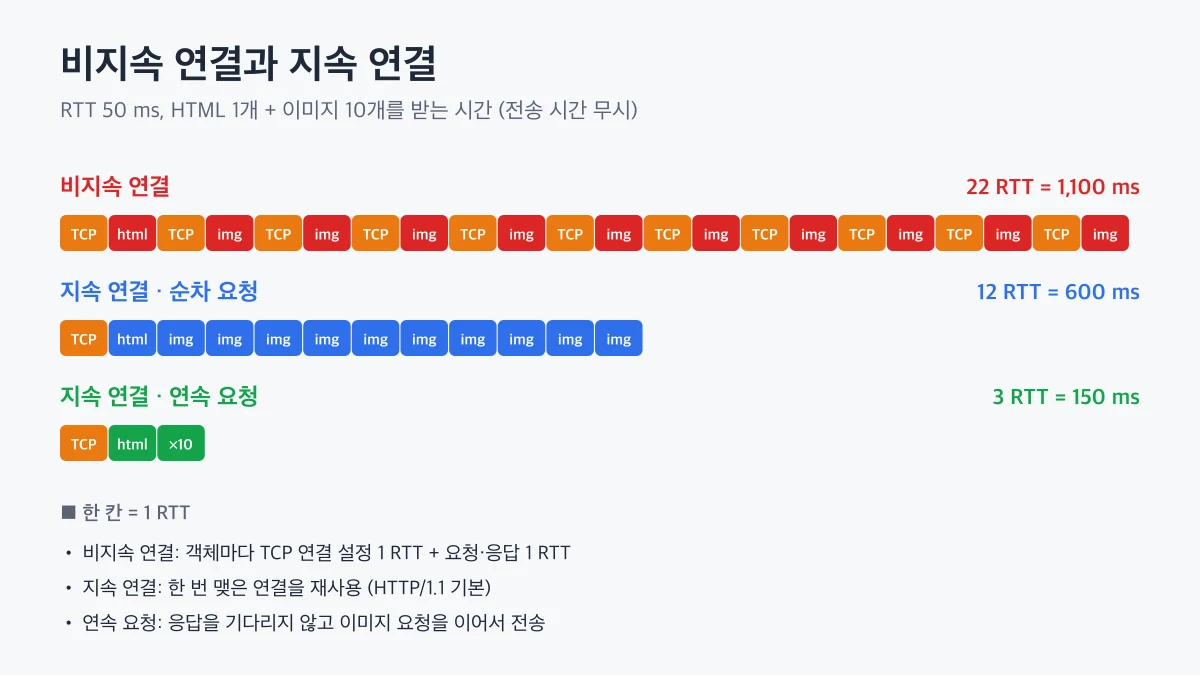
对比非持久连接为每个对象花费 2 RTT 用于建立 TCP 连接和发送请求,而持久连接通过一次建立的连接连续交换多个对象,从而缩短总时间
HTTP/1.1 报文是人类可读的 ASCII 文本。
使用
curl 的
-v 选项,可以看到实际交换的请求头和响应头。
curl -v https://example.com/ -o /dev/null
输出中以 > 开头的行是请求报文。
> GET / HTTP/1.1
> Host: example.com
> User-Agent: curl/8.7.1
> Accept: */*
请求行
由方法、URL 路径和 HTTP 版本组成。方法包括用于获取的 GET、用于发送数据的 POST、用于修改的 PUT、用于删除的 DELETE,以及只获取头部的 HEAD。首部行
Host 首部让用一个 IP 地址提供多个域名服务的服务器知道客户端要访问哪个网站。实体主体
用于 POST 或 PUT 等发送数据的请求。
以 < 开头的行是响应报文。
< HTTP/1.1 200 OK
< Content-Type: text/html
< Content-Length: 1256
< Cache-Control: max-age=3600
第一行
状态行
由 HTTP 版本、状态码和状态短语组成。
| 状态码 | 含义 | 典型场景 |
|---|
| 200 OK | 请求成功 | 正常响应 |
|---|
| 301 Moved Permanently | 永久移动 | 域名或 URL 变更 |
|---|
| 304 Not Modified | 未修改 | 直接使用缓存的对象 |
|---|
| 400 Bad Request | 错误请求 | 请求格式错误 |
|---|
| 404 Not Found | 对象不存在 | 路径不存在 |
|---|
| 500 Internal Server Error | 服务器错误 | 处理过程中发生异常 |
|---|
-v 的输出把 HTTP 报文整理成易读的形式。
从 HTTP/2 开始,同样的语义以
二进制帧
传输,因此在实际数据包中看不到文本形式。
HTTP 是无状态协议,但登录、购物车等功能需要记住用户。
这时使用的就是
Cookie
(cookie)。
- 用户首次访问时,服务器生成一个标识号,并放在响应的
Set-Cookie 首部中发送。
- 浏览器按域名保存这个值。
- 之后每次向同一网站发送请求时,浏览器都会把该值放在
Cookie 首部中发送。
- 服务器用这个值在数据库中查找用户会话。
也就是说,协议本身保持无状态,而
状态保存在客户端的 Cookie 和服务器的存储中
。
🖐️
会话 Cookie 必须设置
HttpOnly、
Secure、
SameSite 属性。
如果缺少这些属性,Cookie 被脚本读取,或通过未加密连接、其他网站发起的请求被发送出去的风险就会增大。
Web 缓存
(web cache)或代理服务器是代替源服务器保存最近的响应并将其返回的服务器。
浏览器向缓存发送请求时,缓存如果有已保存的对象就立即响应,没有就从源服务器获取并保存后再响应。
Web 缓存离用户较近,因此响应时间缩短,机构的外部线路流量也会减少。
这一原理与数据结构中的
缓存与命中率
概念相同,如今 CDN(Content Delivery Network)在全球范围内承担着这一角色。
确认缓存的对象是否与源服务器上的相同的方法就是
条件 GET
(conditional GET)。
缓存会把已保存对象的
ETag 值或
Last-Modified 时间放在请求首部中发送。
curl -sI https://example.com/ | grep -i etag
curl -sI -H 'If-None-Match: "replace-with-etag"' https://example.com/ | head -1
把第一条命令得到的
ETag 值填入第二条命令的
If-None-Match 首部即可。
如果对象没有变化,服务器只发送不带主体的
304 Not Modified,缓存则直接使用已保存的对象。
由于不需要重新接收主体,图片或打包文件越大,效果越明显。
👨💻
对于每次构建文件名都会变化的带哈希文件名的静态文件,请把
max-age 设得很长并指定
immutable。
对于 HTML 这类内容会变化的文档,指定
no-cache 让它每次都发送条件请求,就能
同时获得缓存效果和内容新鲜度
。
HTTP/1.1 在一个连接上按顺序处理请求,因此前面的大响应一旦延迟,后面的小响应也要跟着等待,这就是
队头阻塞
(Head-of-Line blocking)。
HTTP/2
把报文拆分成小帧,在一个 TCP 连接上交错发送多个请求和响应,即支持多路复用
。它还提供首部压缩和流优先级。HTTP/3
使用基于 UDP 的 QUIC
代替 TCP。丢失一个数据包时只有相应的流需要等待,因此消除了 TCP 层面的队头阻塞,并且把连接建立与 TLS 握手合并,使首个响应更快。
HTTP 是运行在 TCP 之上的
无状态请求-响应协议
。
持久连接消除了为每个对象建立连接的开销,大幅缩短页面加载时间;Cookie 则在无状态协议之上保持用户状态。
Web 缓存和条件 GET 避免重复获取同一对象,同时改善响应速度和流量。
页面很慢时,不要只看服务器响应时间,还应在浏览器开发者工具的网络面板中一并检查请求数量、连接复用和缓存命中情况。
下一篇文章将介绍浏览器查找服务器 IP 地址的过程,即
DNS
。