在一台笔记本电脑上,多个浏览器标签页、Slack、音乐流媒体和开发服务器同时在使用网络。
可是网络接口只有一个,到达的数据包上作为目的地址写的只有你的 IP 地址。
操作系统是怎么知道
到达的数据应该交给哪个进程
的呢?
在
上一篇文章 中,我们整理了传输层为进程之间提供逻辑通信的内容。
本文介绍它的核心功能
多路复用
(multiplexing)和
多路分解
(demultiplexing),并比较 UDP 和 TCP 查找套接字的方式有何不同。
多路复用是收集多个套接字的数据、加上首部后发送到网络中;多路分解是把到达的报文段分发给正确的套接字。
多路复用
给发送主机上多个套接字发出的数据加上包含源和目的信息的首部,生成报文段后交给网络层。多路分解
接收主机检查报文段的首部,把数据交付给正确的套接字。
用
上一篇文章 中的比喻来说,收集兄弟姐妹的信件交给邮局就是多路复用,看着收到的信上的名字分发就是多路分解。
TCP 和 UDP 都提供这一功能,它正是传输层
把主机间交付变为进程间交付
的方法。
要实现多路分解,报文段中必须带有指向目的套接字的信息。
因此传输层报文段首部中包含
源端口号
和
目的端口号
。
范围 名称 用途 0 ~ 1023 周知端口 HTTP 80、HTTPS 443、SSH 22、DNS 53 等标准服务 1024 ~ 49151 注册端口 PostgreSQL 5432、MySQL 3306 等应用 49152 ~ 65535 动态·临时端口 由操作系统自动分配给客户端套接字
服务器进程使用固定的端口号,以便客户端能找到它。
客户端通常不指定端口,而是由操作系统挑选一个未被使用的
临时端口
(ephemeral port)。
实际的临时端口范围可能因操作系统设置而异。
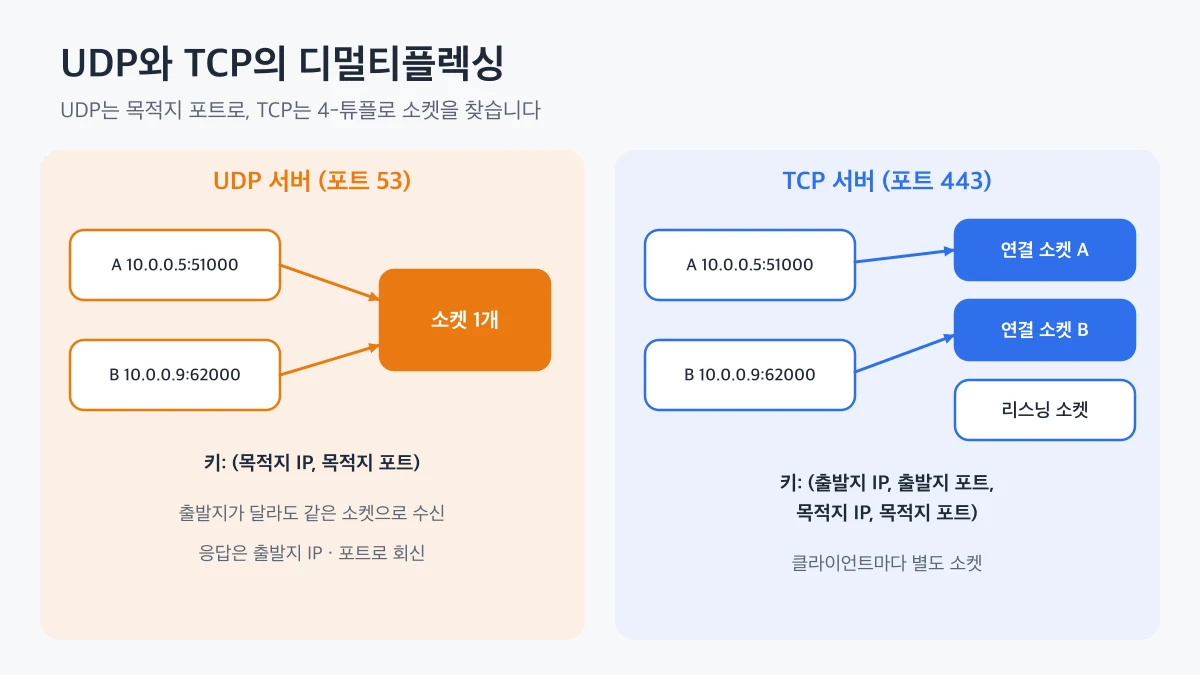
对比 UDP 服务器把目的 IP 和端口相同的报文段不论来源都汇集到一个套接字,而 TCP 服务器根据包含源 IP 和端口的四元组为每个客户端使用单独的套接字
UDP 套接字由
目的 IP 地址和目的端口号
,即二元组来标识。
接收主机查看报文段的目的端口,把数据交付给绑定到该端口的套接字。
因此,
即使来源不同,只要目的端口相同就会进入同一个套接字
。
DNS 服务器用一个 UDP 套接字接收无数客户端的查询,用的就是这种方式。
那么,它是如何回复的呢?
报文段首部中的源 IP 和源端口起到
回信地址
的作用,服务器把这两个值作为目的地发送响应。
udp-demux.mjs import dgram from "node:dgram" ;
const server = dgram. createSocket ( "udp4" ); server. on ( "message" , ( msg , rinfo ) => { console. log ( `${ msg } from ${ rinfo . address }:${ rinfo . port }` ); server. send ( `ack ${ msg }` , rinfo.port, rinfo.address); });
server. bind ( 6060 , () => { for ( const name of [ "client-A" , "client-B" ]) { const client = dgram. createSocket ( "udp4" ); client. on ( "message" , ( reply ) => { console. log ( `${ name } got: ${ reply }` ); client. close (); }); client. send (name, 6060 , "127.0.0.1" ); } setTimeout (() => server. close (), 500 ); }); 两个客户端从不同的临时端口发送数据,但服务器的一个套接字接收了两者的数据。
服务器使用
rinfo 中的源地址和端口进行响应,因此每个客户端只会收到发给自己的响应。
TCP 套接字由
源 IP、源端口、目的 IP、目的端口
四元组来标识。
即使目的端口相同,只要源 IP 或端口不同,就会被交付到
不同的套接字
。
TCP 服务器的工作流程如下。
服务器进程在 443 等端口上打开监听套接字
,等待连接请求。
客户端发送建立连接的报文段后,服务器为该客户端的四元组创建一个新的连接套接字
。
此后该客户端发送的报文段都会交付到四元组匹配的连接套接字。
即使两个浏览器标签页连接到同一台 Web 服务器,两个连接的源端口也不同,因此服务器会用不同的套接字分别处理。
把这个结构理解为数据结构中的
哈希表
会更容易。
操作系统以四元组为键查找连接套接字,即使有数万个连接,也能为每个报文段快速确定目的套接字。
对比项 UDP TCP 套接字标识 目的 IP、目的端口 源 IP·端口、目的 IP·端口 服务器套接字数量 每个端口一个 监听套接字 + 每个连接一个 多个客户端 一个套接字全部接收 每个客户端单独一个套接字
我们在 macOS 上看看连接到 Web 服务器或数据库的 TCP 套接字。
lsof -nP -iTCP:443 -sTCP:ESTABLISHED NAME 列会以
192.168.0.10:52814->203.0.113.5:443 这样的格式显示连接的两端。
箭头左边是你的 IP 和临时端口,右边是服务器的 IP 和 443 端口。
如果同一台服务器出现多行,说明打开了多个只有源端口不同的独立 TCP 连接。
在 Linux 上可以用
ss -tnp,在 Windows 上可以用
netstat -ano 命令查看相同的信息。
👨💻
流量很大的服务器如果不断向其他服务发送短请求,可能会
耗尽临时端口
。
这是因为对于同一个目的地的连接,四元组中只有源端口可以变化。
在 HTTP 客户端中启用 keep-alive 和连接池来复用连接,就能预防这个问题。
传输层在发送端执行
多路复用
,给多个套接字的数据加上含有端口号的首部;在接收端执行
多路分解
,根据首部把数据交付给正确的套接字。
UDP 只用目的 IP 和端口查找套接字,因此一个套接字会接收多个客户端的数据;TCP 则用四元组为每个连接使用单独的套接字。
处理服务器的端口冲突或连接数问题时,请用
lsof 区分监听套接字和连接套接字进行确认。
下一篇文章将详细介绍 UDP 的报文段结构、校验和,以及选择 UDP 的理由。
 多路复用与多路分解