 信源编码
📅
概述(Introduction) 🔗
- 信源符号应编码为二进制。
- 平均码长应尽可能短。
- 消除冗余降低比特率。
- 考虑基于字母表的离散无记忆信源:。
- 的概率:。
- 的码长:。
- 平均码长,即每个符号的平均比特数:。
- 可能达到的最小值:。
- 信源编码效率:。
- 数据压缩。
- 传输前消除冗余信息。
- 进行无损数据压缩。
- 表示离散无记忆信源输出的信源码,应当能够唯一解码。
用于数据压缩的信源编码方案(Source Coding Schemes for Data Compression) 🔗
前缀编码(Prefix Coding) 🔗
任意码字都不是其他码字前缀的可变长度信源码。
- 前缀码的特点。
- 前缀码能够唯一解码。
- 反过来不一定成立:并不是所有唯一可译码都是前缀码。
前缀码示例 🔗
| 符号 | 出现概率 | 编码I | 编码II | 编码III |
|---|---|---|---|---|
| s0 | 0.5 | 0 | 0 | 0 |
| s1 | 0.25 | 1 | 10 | 01 |
| s2 | 0.125 | 00 | 110 | 011 |
| s3 | 0.125 | 11 | 111 | 0111 |
Code1不是前缀码。
Code2是前缀码。
Code3能够唯一解码,但不是前缀码,不易立即区分下一个码字的起点。
以Code2为例:
0101110111 → 0/10/111/0/111,可以唯一解码。
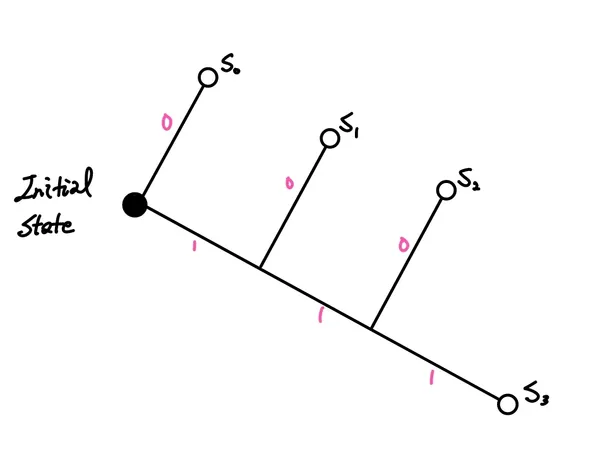
判定树如下。
任意符号以概率出现。
- 概率之和:。
- 平均码长:。
* 霍夫曼编码(Huffman Coding) 🔗
⭐
重要
⭐霍夫曼编码算法 🔗
这是一种常用于数据压缩的方法:给出现频繁的符号分配短码,给较少出现的符号分配长码,从而
压缩数据
。- 按概率从高到低排列符号,将它们作为树的叶节点。
- 重复以下步骤,直到只剩下一个节点。
- 选择概率最小的两个节点,给较小者分配0,较大者分配1。反过来也可以,但必须保持一致。
- 合并两个节点,创建新节点,其概率为两者概率之和。
- 回到第1步重新排列。
- 对每个符号,沿叶节点至根节点的路径生成二进制编码。
- 叶节点对应的比特,是码字的最后一位。
霍夫曼编码的特点 🔗
它属于前缀码。
每个符号的码长,大致等于所传递的信息量。
当概率分布已知且准确时,霍夫曼编码十分有效。
- 方差衡量码长的变化程度。
- 为避免错误,选择方差较大的霍夫曼树。 → 方差较大的树具有更多样的码长,因此能更好地处理错误。
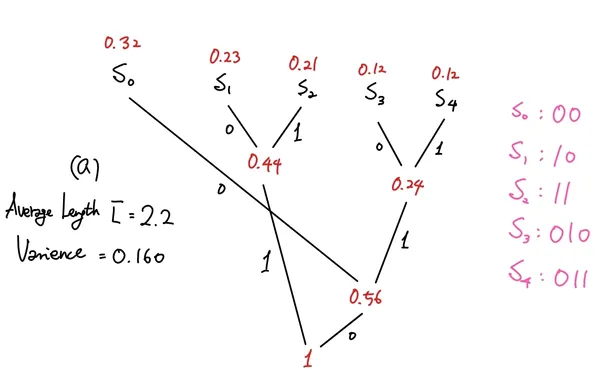
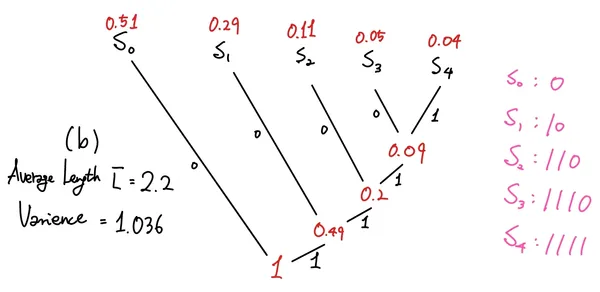
霍夫曼树构建示例(Example of Huffman Tree Construction) 🔗
两棵树的平均码长相同,但
方差
不同。- 方差较大的树能更好地处理错误。